


¿Cerrar sesión?
Vas a salir de tu cuenta en este dispositivo.
OpenAI mide avances de sus agentes: resuelven el 46% de ciertas tareas de investigación
Un informe interno registra fuertes mejoras en actividades de dos a cuatro horas, pero también límites en programación y generación de ideas. El porcentaje no abarca toda la investigación.
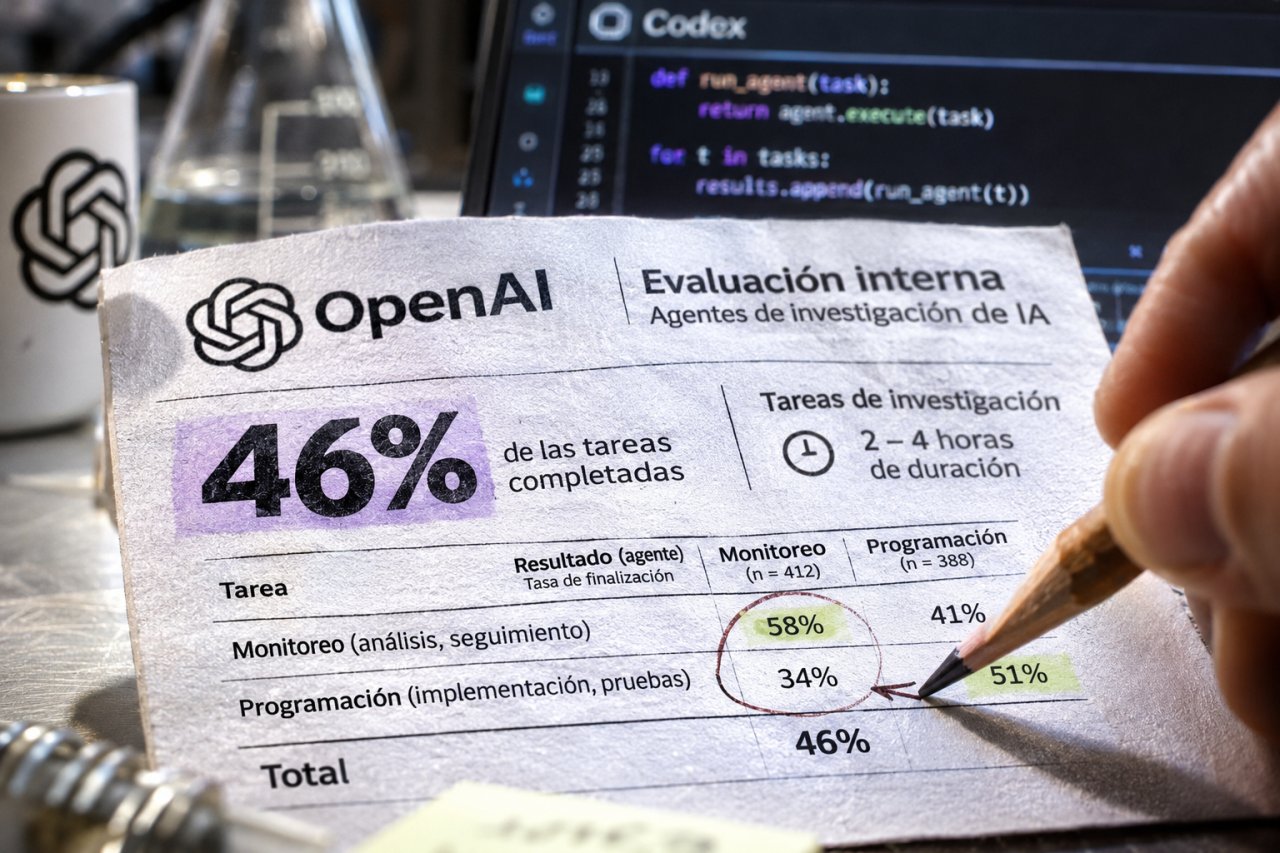

Imagen ilustrativa generada con IA
Los agentes de inteligencia artificial que usan investigadores de OpenAI están resolviendo una proporción creciente de tareas técnicas sin intervención humana durante su ejecución. La empresa publicó el 18 de noviembre de 2026 un informe sobre cómo estas herramientas modifican el trabajo de desarrollo de modelos y qué actividades siguen necesitando supervisión y decisiones de las personas.
El dato más destacado es una tasa estimada de éxito del 46% en tareas que llevarían entre dos y cuatro horas a un trabajador humano. En marzo, esa tasa era del 23%. El 46% no describe todas las tareas de investigación ni significa que casi la mitad de la ciencia se haga sin personas: corresponde a una categoría concreta de encargos delegados a agentes y a una estimación interna de resultados.
Para tareas más largas, calculadas entre cuatro y ocho horas de trabajo humano, la tasa de ejecución sin intervención pasó del 13% al 35% entre marzo y octubre. El aumento indica que la tecnología puede completar trabajos de mayor duración con más frecuencia que antes, aunque su rendimiento no es homogéneo.
OpenAI advierte que las comparaciones requieren cautela. Los investigadores cambiaron los tipos de tareas que delegan a medida que mejoraban las herramientas, por lo que una parte del crecimiento de las tasas puede reflejar decisiones de selección y no solamente un avance en las capacidades del modelo. La empresa también explica que su metodología de medición se actualizó.
La diferencia por especialidad es marcada. De acuerdo con el informe, los agentes resolvieron sin asistencia el 79% de las tareas de monitoreo de entrenamientos analizadas, el 35% de las relacionadas con lanzamiento de entrenamientos y el 25% de las que exigían escribir código para sistemas de inferencia y servicio de modelos.
En una clasificación más amplia de tareas entre agosto y octubre, las categorías de comunicación y análisis registraron tasas estimadas superiores a las tareas de construcción de sistemas. Ese contraste sugiere que los agentes pueden ser eficaces para observar, resumir o revisar información y, al mismo tiempo, mostrar dificultades cuando deben producir componentes técnicos complejos.
La investigación no presenta estos porcentajes como una prueba de autonomía general. Los agentes reciben encargos elegidos y formulados por investigadores humanos, trabajan dentro de sistemas organizados por equipos y sus resultados forman parte de un proceso con revisión posterior. Completar una tarea sin intervención durante la ejecución no significa reemplazar la planificación global ni la validación científica.
El informe también describe un aumento notable del uso diario de herramientas. Calculado según precios de lista de la API, el investigador mediano de OpenAI consumió en octubre el equivalente a unos 2.400 dólares por día en actividad de agentes, un 62% más que en septiembre. En el percentil 90, el valor equivalente llegó a 23.000 dólares diarios.
Esas cifras no representan necesariamente dinero pagado en efectivo por cada investigador. La empresa las utiliza como valoración del consumo interno aplicando precios de lista de servicios comerciales. Su crecimiento refleja una combinación de mayor cantidad de actividad, modelos de distinto costo y cambios en el comportamiento de los sistemas.
Otra medida ayuda a entender la escala. OpenAI calcula la duración acumulada de sesiones activas de agentes en jornadas de ocho horas. Con ese criterio, pasó de 0,5 a 5,7 jornadas equivalentes de agentes por investigador y por día, un aumento de once veces. El valor puede superar una jornada humana porque muchos agentes trabajan simultáneamente.
Esa concurrencia también creció: hacia mediados de octubre, más de dos tercios de los investigadores incluidos en la muestra registraban picos diarios de al menos cuatro agentes funcionando a la vez. Más de una décima parte alcanzaba o superaba dieciséis agentes simultáneos. La medida describe sesiones paralelas, no un único programa que trabaje más horas de las que tiene el día.
El valor de esa asistencia fue consultado a trabajadores de la empresa mediante sondeos internos. En una encuesta de 101 integrantes de investigación, la respuesta mediana a una pregunta hipotética fue que aceptarían perder el 40% de la dotación de su equipo para conservar acceso a agentes avanzados durante tres meses. Es una respuesta a un escenario imaginario, no un plan de despidos ni una decisión laboral.
En otro sondeo, de 28 personas, 27 dijeron que serían más productivas con el modelo interno más reciente que con una combinación de un ingeniero humano de experiencia media y un modelo de 2024. OpenAI aclara que las respuestas personales están sujetas a sesgos de percepción y que las muestras fueron recogidas con métodos que tienen limitaciones.
Una de las preguntas más relevantes del informe es de dónde surgen las ideas. Los investigadores consultados sobre GPT-6 Astra atribuyeron las ideas importantes que identificaron a personas, mientras que los modelos colaboraron en implementarlas. Para GPT-6.2 Astra, algunos miembros de preentrenamiento describieron ideas desarrolladas mediante conversación con Codex.
En uno de esos casos, un investigador atribuyó a Codex perspectivas clave sobre la idea. Otro explicó que la propuesta principal había surgido de él, pero mejoró al incorporar un cambio sugerido por la herramienta. En las áreas de postentrenamiento y monitoreo de seguridad, los investigadores siguieron atribuyendo a personas las ideas centrales que identificaron.
Estas declaraciones no prueban que exista una medida universal de originalidad ni que todos los investigadores respondan igual. Son observaciones cualitativas de participantes en procesos concretos. La empresa las usa para mostrar que la colaboración humano-agente está cambiando y que los límites entre idear, implementar y revisar pueden volverse menos nítidos.
Los propios entrevistados señalaron problemas persistentes. Algunos agentes producen código de baja calidad, análisis con supuestos equivocados, datos inutilizables o caminos innecesarios en los experimentos. También pueden multiplicar los materiales generados y aumentar el trabajo de revisión. La supervisión humana puede convertirse en un cuello de botella aun cuando ciertas actividades se automaticen.
Otro hallazgo de la empresa es el aumento del trabajo humano documentado en seguridad y alineación. Entre enero y septiembre, las semanas de contribución registradas para esas áreas crecieron un 77%, por contrataciones y cambios de dedicación. El informe relaciona parte de esa intensificación con la revisión de incidentes de seguridad y con la necesidad de controles adicionales.
OpenAI sostiene que medir estos fenómenos es importante para evaluar la posibilidad de que los sistemas de IA ayuden a desarrollar sucesores más capaces. Esa perspectiva abre oportunidades de productividad, pero también preguntas sobre supervisión, calidad, verificación independiente y gestión de riesgos. Las cifras se presentan como una medición parcial del proceso, no como prueba de que la mejora se sostendrá a un ritmo determinado.
La conclusión principal es que hay avances concretos, pero desiguales: ciertas tareas de investigación ya se realizan con autonomía operativa significativa y otras siguen siendo difíciles. El 46% corresponde a un conjunto definido de encargos de dos a cuatro horas y no debe extrapolarse a toda la investigación científica. Las personas continúan eligiendo problemas, interpretando resultados y decidiendo cómo avanzar.
Referencias
Comentarios (0)
Todavía no hay comentarios. Sé el primero.
Para comentar tenés que estar registrado. La nota se lee sin login.
Entrar con Google Seguir en el tablón